Как любая технология КонтрПлагиат состоит из этапов:
Первый — подготовительный, очистка текста от форматирования и сохранение значимой информации:
— если в тексте расставлены автоматические переносы, убрать их;
— если текст содержит подстрочные ссылки, необходимо преобразовать их во внутритекстовые, в квадратных скобках, рис. 4.
Последовательность действий в среде Word, «Главная» — «Заменить».
Перед заменой убедитесь, что нумерация сносок сквозная, а не постараничная. Исправить постраничную нумерацию можно с помощью меню, «Нумерация» — «Продолжить», рис. 3.
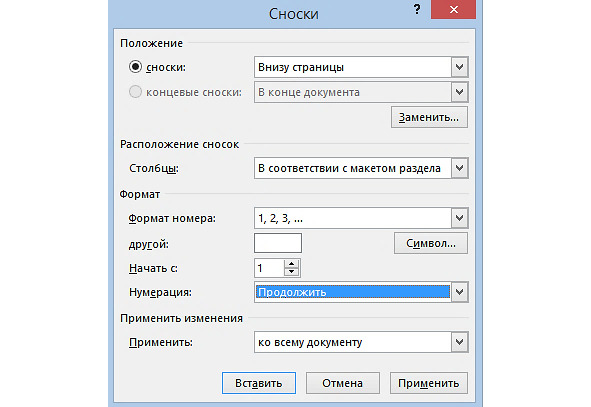
Рисунок 3 — При конвертации подстрочных ссылок во внутритекстовые — следите, нумерация подстрочных ссылок должная быть сквозной, а не постраничной
В интерфейсе окна «Найти и заменить» — в строке «Найти» проставляем специальный набор символов «Знак сноски», в строке «Заменить» — «Пробел, открывающаяся квадратная скобка, специальный набор символов «Искомый текст», закрывающаяся квадратная скобка. Действие — «Заменить все».
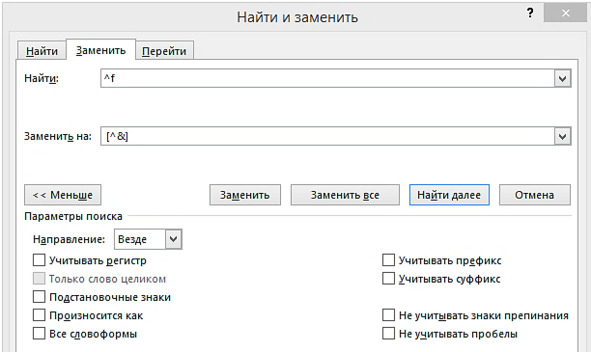
Рисунок 4 — Символы конвертации подстрочных ссылок во внутритекстовые
После исполнения последовательности действий все подстрочные ссылки будут заменены на внутритекстовые, рис. 5.

Рисунок 5 — Итог конвертации ссылок
Полученный документ необходимо сохранить в формате *.txt, рис. 6, «Тип файла» — «Обычный текст».
В ответ на предупреждение, соглашаемся — «Ок», рис. 7.
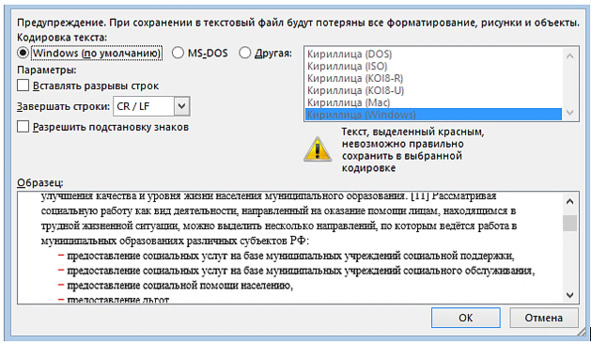
Рисунок 6 — Настройки конвертации формата *.doc в *.txt
В ответ на следующий вопрос MS Word отвечаем утвердительно — «Ок», рис. 7.
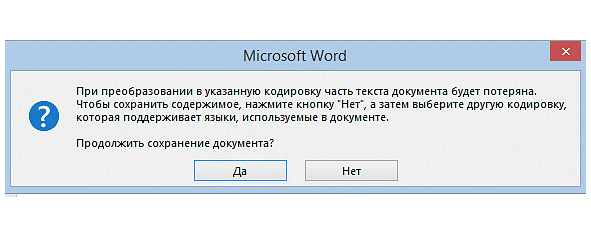
Рисунок 7 — Финальное подтверждение условий конвертации
Открываем сохраненный текстовый файл в любом редакторе для текста, мы используем EditPlus 4.3 (build 1256) 64-bit, рис. 8.
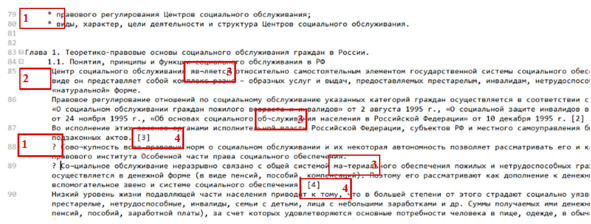
Рисунок 8 — Сконвертированный текст в интерфейсе текстового редактора
Как видно из рисунка 8, текст содержит дефекты форматирования:
1) маркированные списки не имеют однообразного оформления, поэтому обозначены в виде звездочки (*) и знака вопроса (?), исправить маркер можно применением функции «Найти» — «Заметить».
2) Табуляционный отступ, оставшийся из среды Word, заменяется аналогично, меню «Найти» — «Заметить», команда — «Заменить все».
3) Текст содержит знак переноса (¬), который мы также заменим: «Найти» — «Заметить», команда — «Заменить все», рис. 9.
4) Внутритекстовые ссылки представлены в квадратных скобках, поэтому оставляем их без изменения.
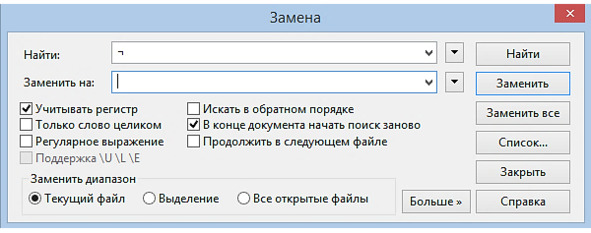
Рисунок 9 — Удаления артефактов «знак переноса»
Аналогичным образом заменяются все дефектные элементы форматирования, которые имеет текст.
Полученный, чистый текст, копируем (с введения и до списка литературы) и вставляем в правое окно приложения AntiPlagiarism.NET, программу можно скачать бесплатно на сайте etxt.ru, рис. 10.
По итогу мы должны иметь текст для сверки, в правом окне приложения AntiPlagiarism.NET и очищенный от форматирования текст в текстовом редакторе.
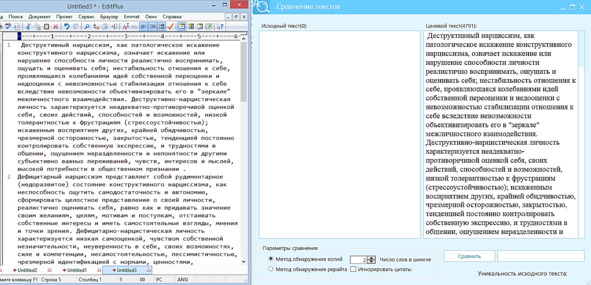
Рисунок 10 — Слева, очищенный от артефактов текст, справа — вставка текста в правое окно AntiPlagiarism.NET
Второй — разработка инструкции для GPT.
Как правило человеческие тексты, перефразированные с помощью ИИ GPT, не становятся генеративными, это связано лексическим и семантическим разнообразием таких текстов. Перед разработкой инструкции важно провести диагностику текста, в простейшем случае, диагностика дает понимание с каким текстом мы имеем дело, в п. 5.1. данный вопрос рассмотрен на наглядном примере. Выявление заспамленности — еще один вид анализа. Если текст заспамлен, в инструкции стоит указать требование, заменить все высокочастотные слова и выражения на синонимы, или прямо запретить употребление определенных слов и выражений, например, запрещено употреблять слово «банк», вместо этого употребляй выражение, кредитно-финансовые организации банковского сектора и сходные синонимичные выражения.
Разрабатывая инструкцию для GPT необходимо ответить себе на вопрос, что мы желаем получить в ответе ИИ. Задаем требования:
— нужно перефразировать текст так, чтобы он стал уникальным по отношению к источнику (контексту);
— нужно сохранить все ссылки, которые заключены в квадратных скобках;
— при глубоком рерайте нужно изменить предложения, например — простые объединить в сложные, сложные преобразовать в простые, коротко это можно назвать так — повысь семантическое разнообразие текста, используй разные по длине предложения, примени прямой и обратный порядок слов;
— если текст источника не академический, то нужно задать требование: стиль академический, формальный, от третьего лица;
— при глубоком перефразировании желательно изменять абзацы, поэтому об этом стоит сказать — переформируй абзацы исходя из смысла текста.
Все многообразие наших пожеланий вставляем в окно GPT и просим написать инструкцию, рис. 11.
Напиши инструкцию для перефразирования текста в GPT, учитывая обязательные требования:
— нужно перефразировать текст так, чтобы он стал уникальным по отношению к источнику (контексту);
— нужно сохранить все ссылки, которые заключены в квадратных скобках;
— при глубоком рерайте нужно изменить предложения, например — простые объединить в сложные, сложные преобразовать в простые, коротко это можно назвать так — повысь семантическое разнообразие текста, используй разные по длине предложения, примени прямой и обратный порядок слов;
— если текст источника не академический, то нужно задать требование: стиль академический, формальный, от третьего лица;
— при глубоком перефразировании желательно изменять абзацы, поэтому об этом стоит сказать — переформируй абзацы исходя из смысла текста.
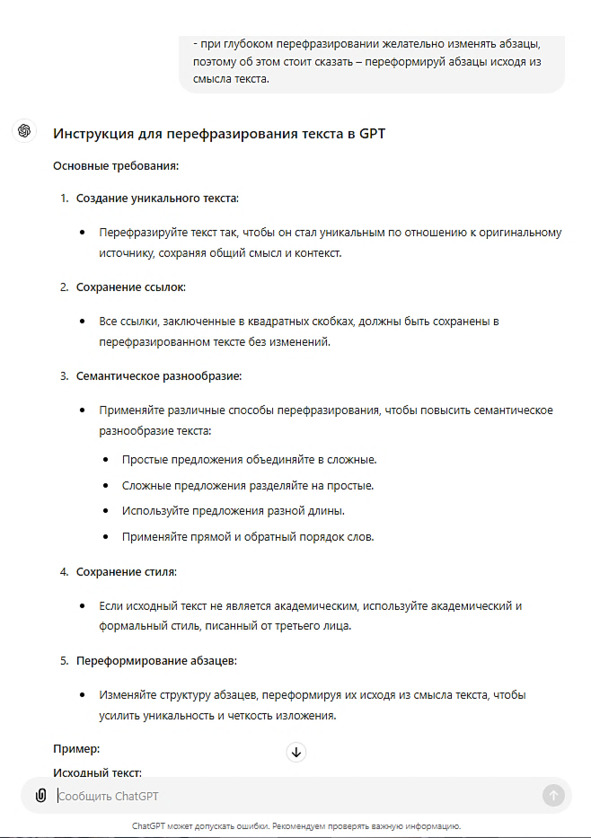
Рисунок 11 — Обобщение требований инструкции для GPT на естественном языке
Оформляем полученный GPT-ответ в промпт.
Prompt:
Перефразируйте текст так, чтобы он стал уникальным по отношению к контексту, сохраняя общий смысл контекста.
— Все ссылки, заключенные в квадратных скобках, должны быть сохранены в перефразированном тексте без изменений.
— Применяйте различные способы перефразирования, чтобы повысить семантическое разнообразие текста:
— Простые предложения объединяйте в сложные.
— Сложные предложения разделяйте на простые.
— Используйте предложения разной длины.
— Применяйте прямой и обратный порядок слов.
— Если исходный текст не является академическим, используйте академический и формальный стиль, писанный от третьего лица.
— Изменяйте структуру абзацев, исходя из смысла текста, чтобы усилить уникальность и четкость изложения.
context:
Используя переводчик DEEPL (как самый точный) переводим нашу инструкцию на английский язык, рис. 12.
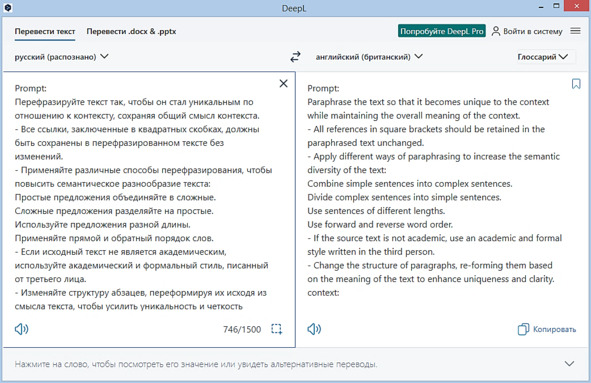
Рисунок 12 — Перевод инструкции с русского языка на английский
Полученный промпт вставляем в текстовый редактор EditPlus, в котором содержится очищенный от форматирования текст, рис. 13.
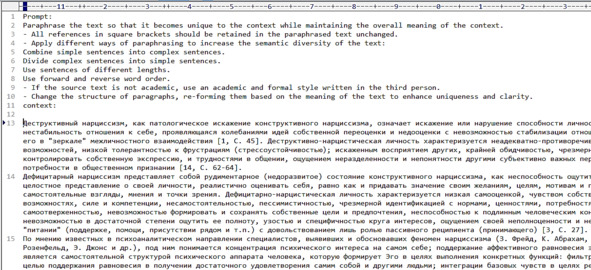
Рисунок 13 — Объединение инструкции, промпта для GPT с текстом.
Третий — глубокое перефразирование контекста.
— Скопируйте в буфер до 5000 знаков текста источника и переведите его в translate. google на английский язык, рис. 14.
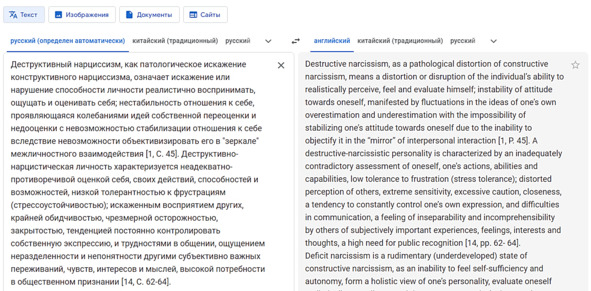
Рисунок 14 — Перевод текста в translate. google с русского на английский
— Полученный английский текст вставьте в EditPlus, заменив текст на кириллице, рис. 15.
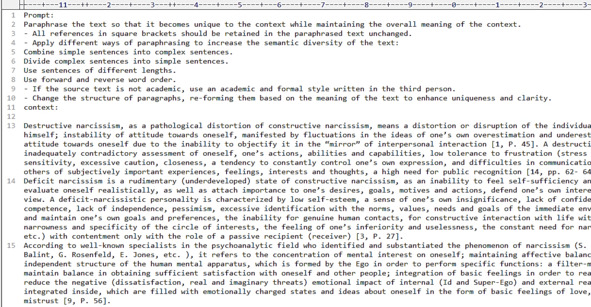
Рисунок 15 — Финальная подготовка материала для перефразирования
— Скопируйте промпт, вместе с английским текстом в буфер обмена, например первый абзац и вставьте данный текст в окно GPT, отправьте текст на перефразирование.
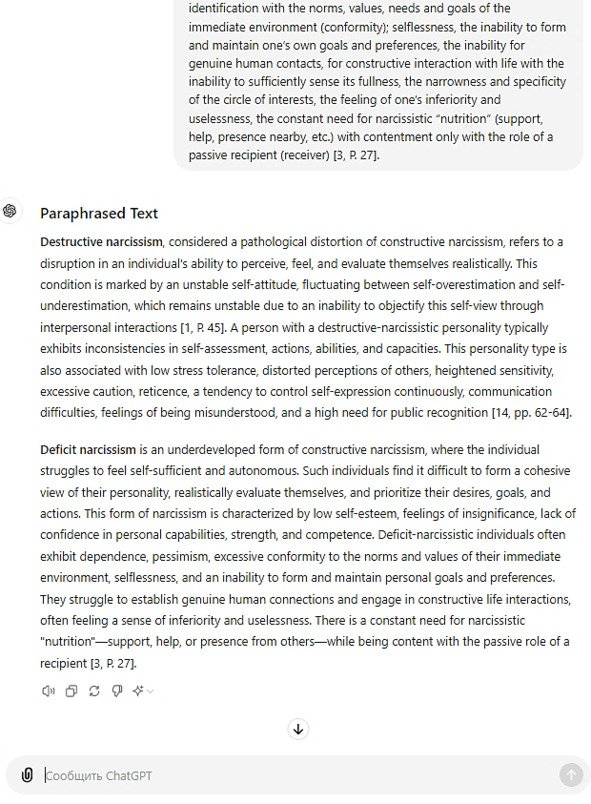
Рисунок 16 — Получение ответа GPT 3.5, перефразированный текст
— Полученный перефразированный текст, рис. 16, перевидите в translate. google или DEEPL на русский язык и вставьте этот текст в левое окно AntiPlagiarism.NET, рис. 17.
По времени данная операция (скопировать промпт и английский текст, вставить в GPT, дождаться завершения исполнения, скопировать в буфер) занимает меньше 30 сек.
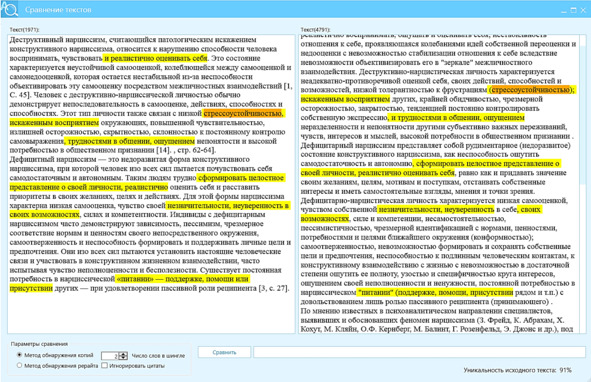
Рисунок 17 — Процесс сверки текста: левое окно — текст после перефразирования, правое окно — текст источника (донор)
Как видно, в результате перефразирования мы получили текст с отличием Ш2 = 91%. Текст имеет тот же объем, что и контекст.
Полученный текст рерайта представляет собой глубокий рерайт, сам текст высокочастотный, поэтому прибегнем к КонтрПлагиата, разобьём шинглы из двух слов, которые выделены желтым в левом окне. Для удобства вашего восприятия все новые слова «вставки» мы выделили прописными буквами, рис. 18.
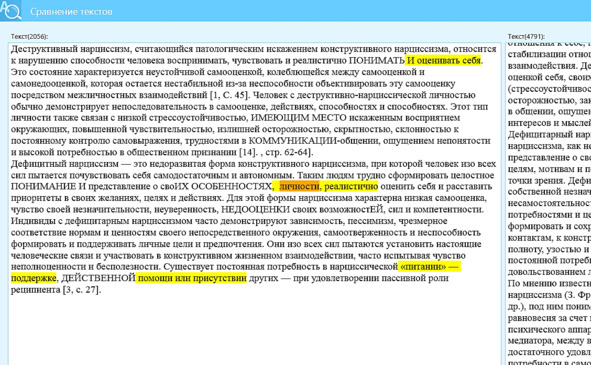
Рисунок 18 — Ручное разбиение шинглов, которые небыли перефразированы (текст желтых блоков)
Впечатывание 8 слов заняло ок. 1 мин., ручная работа осуществлялась скальпирующем методом, исправлено 2000 знаков текста, другими словами, мы правили те места, которые не поддались GPT-рерайту, результат данных изменений дал отличие Ш2 = 98%, рис. 19.

Рисунок 19 — Результат сверки текстов по методу Ш2, левое окно — текст после рерайта, правое окно — текст источник, отличие Ш2 =98%
Общее время, затраченное на рерайт 2 000 знаков — ок. 2 минут, следовательно, скорость КонтрПлагиата — 1 000 знаков в минуту. ВКР, объемом 100 тыс. знаков возможно перефразировать меньше чем за 2 часа.
Качество текста возможно оценить в Приложении 3. Обратите внимание, согласно уведомлению OpenAI — «ChatGPT может допускать ошибки. Рекомендуем проверять важную информацию». Освободив себя от рутины, мы имеем возможность придаться творческому процессу, вычитать текст и поправить все неточности.
Резюмируя, отметим, КонтрПлагиат дает возможность получить текст рерайта с отличием Ш2 — более 95%. Обобщенно процесс состоит из этапов:
— Первый — подготовительный.
— Второй — разработка инструкции для GPT.
— Третий — глубокое перефразирование контекста.
Этапы можно оптимизировать, GPT дает примерно одинаковый по качеству текст, поэтому подготовительный этап можно сократить, если вы занимаетесь рерайтом системно, то как правило у вас уже имеется рабочая инструкция, поэтому второй этап также может быть сведен к минимуму. Оптимизация первого и второго этапа позволяет достичь показателя скоростного рерайта — 1 000 знаков в минуту.
6.4. Как превратить генеративный GPT текст в человеческий и убрать статус подозрительного документа
Что такое генеративный текст, можно спросить у GPT. Антиплагиат ВУЗ, равно как и OpenAI не умеют выявлять генеративность. Отличие между этими двумя коммерческими структурами в том, что OpenAI открыто в этом призналась.
Итак, не один детектор генеративности никогда не умел находить генеративные тексты. После гордого заявления антиплагита все стали свидетелями бесчисленных глюков проверок, например, пустой лист — генеративен, содержание, нумерация страниц, подстрочные ссылки и даже святая святых, библиографический список, все они могли оказаться генеративными.
Антиплагиат, объявивший весной 2023 г. о бета-детекторе, спустя год не вышел в альфу и не стал рабочим модулем. Поспешив включить детектор генеративных текстов в состав базовых модулей, антиплагиат вызвал увеличение количества проверок пользователей, каждый раз доказывая, что это «экспертная» система.
В Интернете много «мутных» публикаций о том, что отличает генеративный текст от человеческого, пишут о водяных знаках, встроенных кодах, которые оставляют цифровые следы и т. д. Исходя из аксиомы, которую озвучила OpenAI, все это не представляет когнитивного интереса, потому что генеративные тексты сегодня не определяются и не будут определяться в будущем. Следовательно, все Интернет-домыслы — это фантазии на тему поиска блохи в стоге сена.
Переходя в практическую плоскость, обратимся к статусу — «Внимание, документ подозрительный: в документе присутствует сгенерированный текст», который антиплагиат навешивает налево и направо. Этот статус подразумевает, что текст, который проверен в антиплагиат ВУЗ — генеративный, другими словами написанный искусственным интеллектом (GPT, ChatGPT). Исходя из аксиомы от OpenAI, проблема не в том, как сделать генеративный текст человеческим, а в том, как преодолеть бета-новацию антиплагиата, который ВУЗ.
Мы уже писали, что представительная группа студентов, вообразили себя гуру, которые овладели GPT, поэтому мощную систему, называемую искусственным интеллектом, начали использовать как расширенную версию поисковика. Примитивные запросы к GPT, ChatGPT породили примитивные тексты, которые антиплагиат ру заслуженно метит как генеративные.
Давайте начнем сначала — тексты, сгенерированные GPT, ChatGPT сегодня не может определить ни один детектор. Поэтому GPT и ChatGPT могут успешно использоваться при написании научных работ, а также для очеловечивания текстов.
Волшебное слово, которое нужно употреблять вовремя GPT-запросов, это конкретизация того, что вы хотите получить.
Приведем несколько примеров излечивания GPT-текстов. Дан текст, написанный человеком: «Деструктивный нарциссизм, как патологическое искажение конструктивного нарциссизма, означает искажение или нарушение способности личности реалистично воспринимать, ощущать и оценивать себя; нестабильность отношения к себе, проявляющаяся колебаниями идей собственной переоценки и недооценки с невозможностью стабилизации отношения к себе вследствие невозможности объективизировать его в „зеркале“ межличностного взаимодействия [1, С. 45]. Деструктивно-нарциссическая личность характеризуется неадекватно-противоречивой оценкой себя, своих действий, способностей и возможностей, низкой толерантностью к фрустрациям (стрессоустойчивостью); искаженным восприятием других, крайней обидчивостью, чрезмерной осторожностью, закрытостью, тенденцией постоянно контролировать собственную экспрессию, и трудностями в общении, ощущением неразделенности и непонятности другими субъективно важных переживаний, чувств, интересов и мыслей, высокой потребности в общественном признании [14, С. 62—64]».
Проверка в GPTZero, показывает, что текст на 48% генеративный, рис. 20, openai-openai-detector. hf. space считает этот текст фейковым, генеративным на 81%, рис. 21.

Рисунок 20 — Проверка текста, написанного человеком в GPTZero
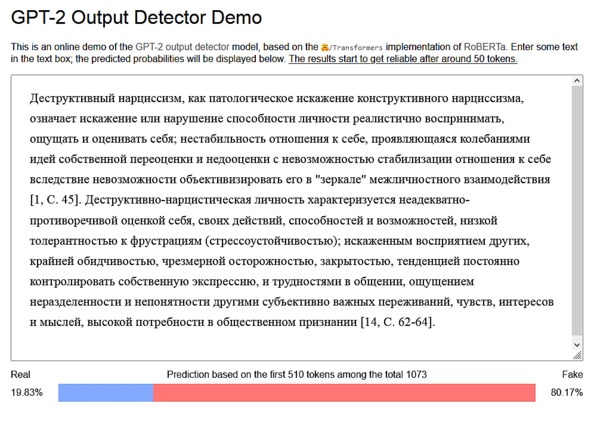
Рисунок 21 — Проверка текста, написанного человеком в openai-detector
Этот эксперимент показывает, что человеческий текст крайне неубедительно детектируется как текст, написанный человеком, в нашем примере, рис. 20 и 21, детекторы классифицируют текст, написанный человеком, как генеративный.
Выше мы сгенерировали рерайт текста, проверим его на генеративность, рис. 22.

Рисунок 22 — Проверка текста GPT-рерайта в GPTZero
Как видно из рис. 22, по версии GPTZero, после обработки текста в ChatGPT, его человечность повысилась и стала равна 50%, искусственного интеллекта, генеративности, в данном тексте 34%.
Давайте проведем эксперимент, сгенерируем текст на русском языке, рис. 23.
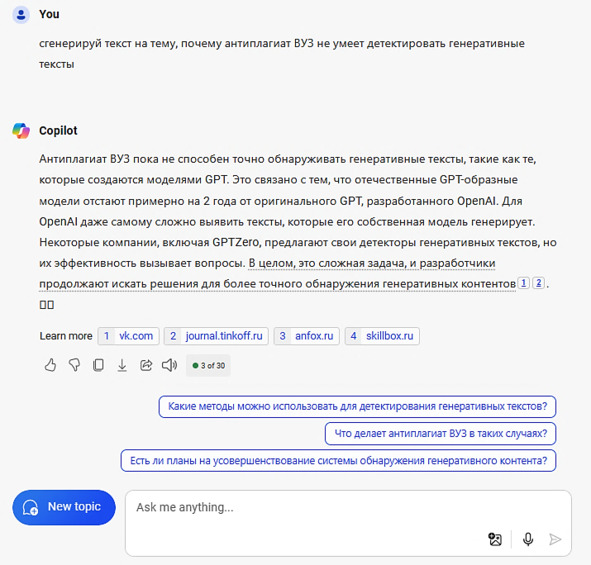
Рисунок 23 — Генерация текста примитивным промптом-инструкцией
Данный текст проверим на генеративность, рис. 24.
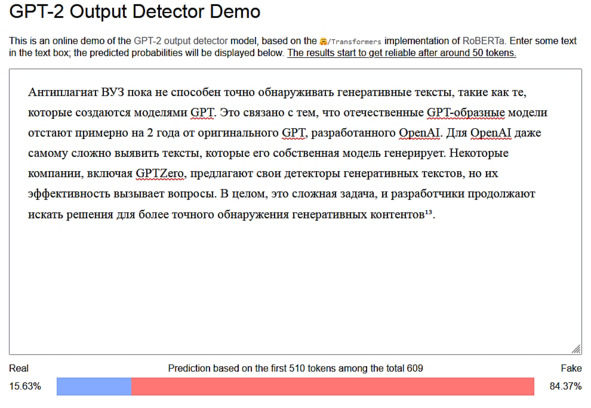
Рисунок 24 — Детектирование генеративности в openai-detector
Как видно из рисунка 24, в генеративном тексте генеративности столько же как и в человеческом тексте, с разницей в 4%.
Переведем текст на английский язык с помощью переводчика, в котором не используется ИИ, это старый, отечественный ПРОМТ, рис. 25.
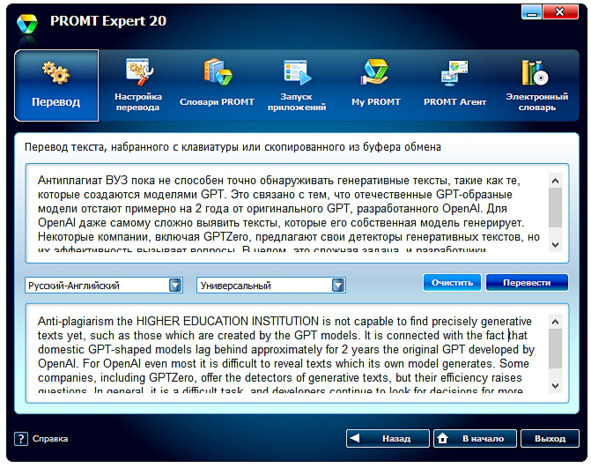
Рисунок 25 — Перевод текста на английский язык в PROMT 20
Полученный английский текст проверим на генеративность, рис. 26.
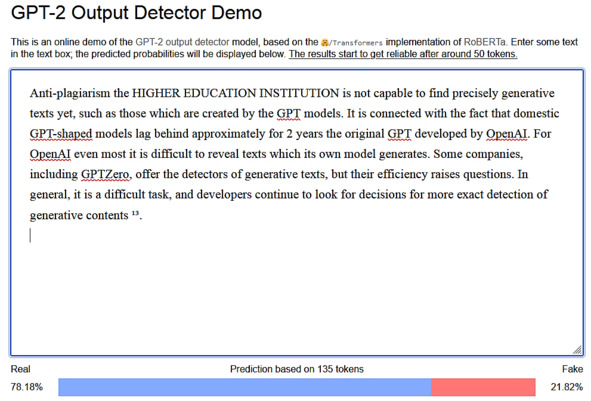
Рисунок 26 — Проверка английского текста после перевода в PROMT сервисом openai-detector
Ситуация кардинально поменялась, наш текст очеловечился с заметным отрывом.
Исходя из полученных результатов проведем эксперимент с генеративным текстом, рис. 27.
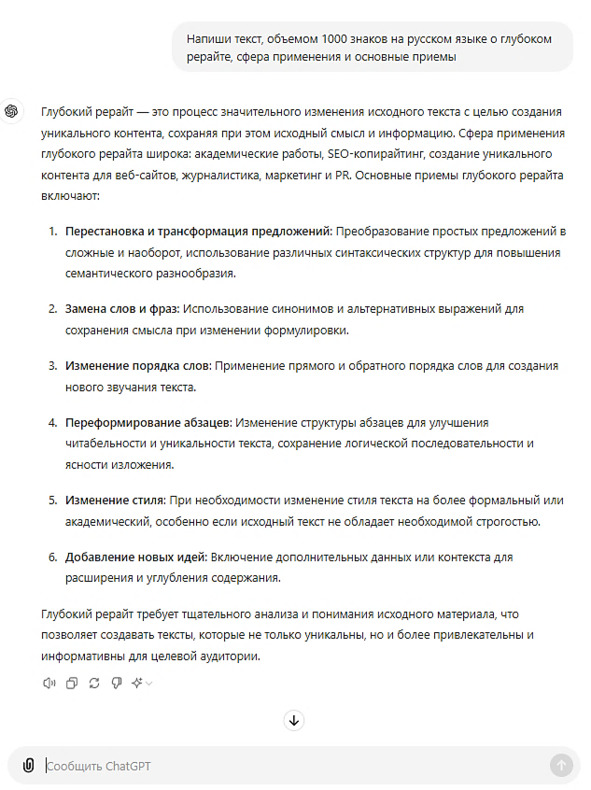
Рисунок 27 — Ответ GPT на примитивную инструкцию «Сгенерируй текст…»
GPT тексты грешат маркированными списками, в которых «зашита» тавтология, несмотря на это, по версии GPTZero наш текст считается человеческим на 69%, рис. 28.
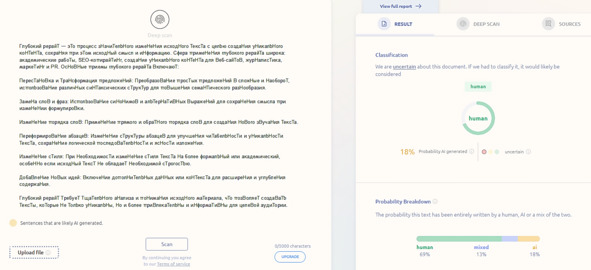
Рисунок 28 — Детектирование текста в GPTZero
Переведём наш генеративный текст на английский и применим к нему промпт, который применяли для рерйта, полученный текст проверим еще раз, рис. 29.
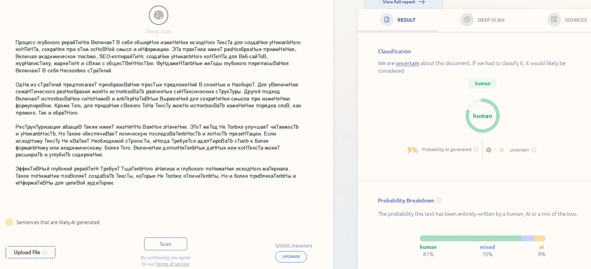
Рисунок 29 — Детектирование текста в GPTZero после применения GPT и переводчика Google
Как видно GPTZero считает этот текст человеческим на 81%, только 9% содержания текста отнесены к генеративному. Напомню, что выше мы тестировали текст, написанный человеком, GPTZero нашел в нем 48% генеративного текста, однако, текст, который мы сгенерировали показал всего 18% генеративности, а после рерйта — 9% генеративности.
Что делать с генеративным текстом, спросите у GPT, какой текст считается генеративным, какие маркеры отвечают за детектирование ИИ в тексте, см. п 4.1.
Генеративные тексты характеризуются — однообразием, все предложения составляются по одному шаблону; это формализованные тексты, т.к. их пишет машина, а не человек; ИИ тексты грешат тавтологией и отсутствием анализа, и доказательностью.
Стоит ли проверять свои тексты в сервисах детектирования, отличных от антиплагиат, версии ВУЗ — нет, не стоит, т.к. все сервисы используют разные алгоритмы и результирующе показатели не валидны антиплагиат ВУЗ.