Распространение генеративных языковых моделей изменило характер академической проверки. Если классические системы антиплагиата ориентированы преимущественно на выявление текстовых заимствований, то ИИ детекторы, например «Антиплагиат ВУЗ» анализируют статистические характеристики самого текста. Почему статистические - это дешевле, с точки зрения расходования вычислительных ресурсов. Поэтому очеловечивание текста не может сводиться к механической синонимизации: для изменения результата проверки необходимо учитывать количественные свойства синтаксической и вероятностной организации академического текста.
Принцип работы разработанного в КонтрПлагиат компонента был установлен экспериментально. ИИ детектор «Антиплагиат ВУЗ» рассматривался как «чёрный ящик»: на вход анализатора КонтрПлагиат подавались различные редакции отчетов Антиплагиат.ВУЗ, после чего полученная разметка сопоставлялась с измеряемыми характеристиками выделенных (ИИ) и невыделенных фрагментов. Проверялись длины внутрипредложенных фраз, вариативность синтаксического ритма, вероятностная предсказуемость текста, разнообразие n-грамм и плотность прагматических конструкций, всего более 60 методов анализа. Общая последовательность экспериментальной реконструкции показана на рисунке 1.
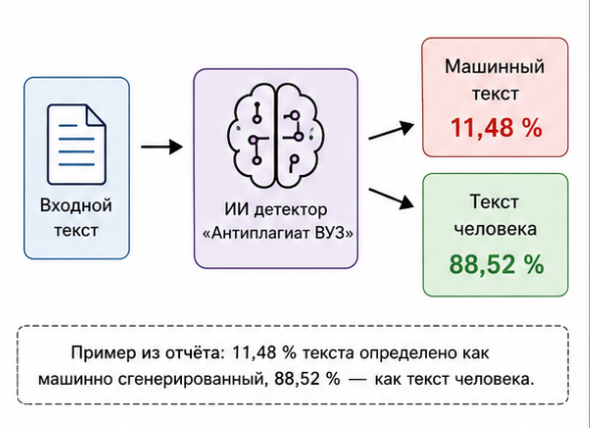 Рисунок 1 – Экспериментальная реконструкция работы ИИ детектора «Антиплагиат ВУЗ»
В ходе экспериментов математически зависимые признаки последовательно исключались. В частности, burstiness оказался однозначной функцией коэффициента вариации CV (1):
B = (CV - 1) / (CV + 1), (1)
Следовательно, одновременное использование burstiness и CV приводило бы к повторному учёту одной и той же характеристики синтаксического ритма.
Первый уровень компонента основан на метрике M1 — коэффициенте вариации длины внутрипредложенных фраз. В качестве базовой единицы анализа используется абзац. Из всех содержащихся в нём предложений формируется единый вектор длин фраз (2):
L_A = (l1, l2, l3, ..., ln), (2)
где li — количество слов в i-й внутрипредложенной фразе, а n — общее число фраз в абзаце. Средняя длина фразы рассчитывается по формуле (3):
mu = (1 / n) * sum(i=1..n) li. (3)
Генеральное стандартное отклонение определяется по формуле (4):
sigma = sqrt((1 / n) * sum(i=1..n) (li - mu)^2). (4)
На основании полученных величин вычисляется M1 (5):
M1 = CV_phrase = sigma / mu, (5)
Решающее правило задаётся порогом 0,55 (6):
M1 <= 0.55 -> класс ИИ;
M1 > 0.55 -> класс Человек. (6)
Последовательность расчёта M1 и переход от абзаца к классификационному решению представлена на рисунке 2. Такой способ устраняет проблему однофразовых предложений, для которых стандартное отклонение неизбежно равно нулю, и позволяет оценивать ритмическую организацию законченного абзаца как единого статистического объекта.

Рисунок 2 – Расчёт метрики M1 на уровне абзаца
Второй уровень компонента представляет собой трёхмерную центроидную модель. Классификационный вектор предложения задаётся формулой (7):
X = [PPL, H2, D_pragm], (7)
Показатель PPL характеризует вероятностную предсказуемость текста, H2 — энтропию Реньи для биграмм и триграмм, а D_pragm — плотность прагматических конструкций. После масштабирования признаков статистический профиль предложения сопоставляется с центроидами классов «ИИ» и «Человек». Класс определяется по минимальному расстоянию до соответствующего центроида. Принцип такого решения показан на рисунке 3.

Рисунок 3 – Центроидная 3D-модель классификации
Как показали проведённые эксперименты, центроидная модель обеспечила 98,6 % точности воспроизведения решений ИИ детектора «Антиплагиат ВУЗ» на контрольной выборке. Полученный показатель является результатом фактического сопоставления классификационных решений разработанной модели с разметкой «Антиплагиат ВУЗ», а не прогнозной оценкой.
В итоговом компоненте M1 и центроидная модель используются совместно. M1 характеризует ритмическую структуру абзаца, тогда как 3D-модель оценивает статистические свойства конкретного предложения. Финальное решение определяется правилом (8):
M1 = ИИ AND 3D = ИИ -> машинно сгенерированный текст;
иначе -> текст человека, (8)
Схема совместной работы двух уровней представлена на рисунке 4. Пастельно-красным цветом выделяются только предложения, для которых одновременно выполнены оба условия. Такой механизм позволяет применять компонент не только для предварительной проверки, но и для контролируемого очеловечивания текста: после выявления проблемного фрагмента изменяется его синтаксическая организация, после чего выполняется повторная проверка.
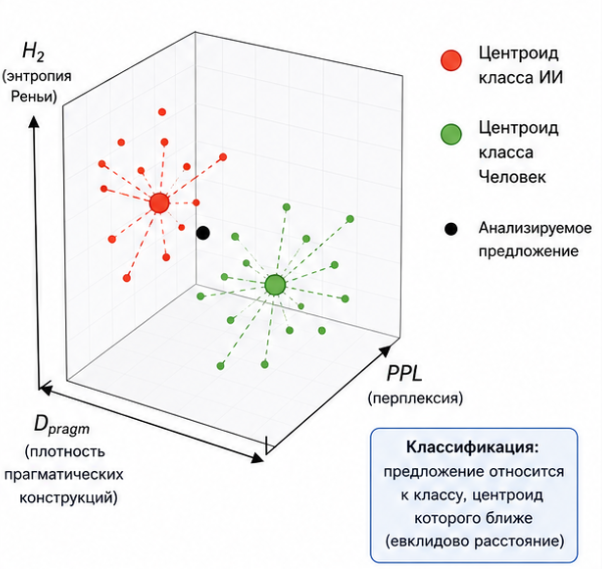
Рисунок 4 – Совместная работа M1 и 3D-модели
Полученная модель представляет собой экспериментально построенную математическую реконструкцию наблюдаемой логики ИИ детектора «Антиплагиат ВУЗ», а не копию закрытого программного кода системы. Её практическое преимущество состоит в интерпретируемости решения: результат можно связать с конкретными количественными характеристиками — коэффициентом вариации фраз, перплексией, энтропией и прагматической плотностью. Это позволяет использовать компонент при предварительной проверке текста на ИИ, диагностике машинного ритма и академическом очеловечивании текста перед проверкой в «Антиплагиат ВУЗ».