Все, опубликованные в Интернет методы повышения уникальности, синонимизация, замена букв и т. д. как правило давно не работают. Достаточно хорошо работает рерайт, но это трудоемкий метод, и он не дает гарантированный результат, процентов уникальности, как правило не хватает.
Что такое рерайт, с точки зрения антиплагиата — это изменение последовательности хешей (числовых значений) к тексту источников. В компьютерной практике существует аналоговый вид предоставления текстов (то, что мы видим на экране) и цифровой (как это сохраняется на жестком диске). Цифровая среда оперирует цифровым предоставлением данных, это нужно учитывать при рерайте.
Самым популярным способом поиска плагиата выступает метод поиска шинглов, рис. 11:
— польский антиплагиат (Strikeplagiarism (Plagiat.pl)) ищет конгруэнтные шинглы, состоящие из 5 и 25 слов;
— Руконтекст ищет шинглы из двух слов, не применяя модуль поиска перефразирования;
— Антиплагиат ВУЗ ищет шинглы из 2 слов, применяя модуль поиска перефразирования (поиск рерайта) что занижает показатель уникальности, при отличии всех шинглов менее чем на 80%, примерно на 10—15%.
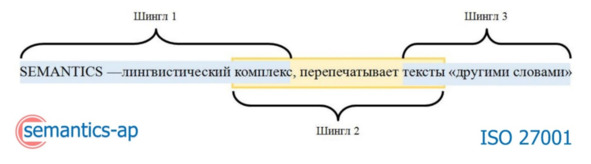
Рисунок 11 — Шинглы из 3 слов
В этой связи актуален вопрос, как быстро сделать рерайт. Рерайтеры исходят из аналогового понимания процесса, видим слово или словосочетание — меняем. Мы исходим из цифрового понимания — есть шингл, например из 2 слов, он должен быть изменен. Данный подход рушит карту хещ значений текста, поэтому он эффективен.
Для реализации данного подхода нужен инструментарий, например нейросетевое решение КонтрПлагиат. Если возможности оплатить услуги академической нейросети перефразирования нет, можно воспользоваться сборкой инструментов, которые существенно снизят трудозатраты рерайтинга.
Вам понадобится программа AntiPlagiarism.NET, как пользоваться программой, см. в Приложении 1.
Дополнительно вам потребуется переводчик Google и семантический анализатор текста, который умеет считать и ранжировать ключевые слова: miratext.ru.
Последовательность действий следующая, устанавливаем языки (переводим с русского на азербайджанский), исходный текст, вставляем в левое окно переводчика GOOGLE, полученный перевод, подвергаем обратному переводу, нажимаем на значок обратного перевода ТРИ РАЗА, рис. 12. Этот же исходный текст вставляем в правое окно программы AntiPlagiarism.NET (интерфейс: операции — сравнение текстов — метод обнаружение копий, количество шинглов — 2), рис. 13.
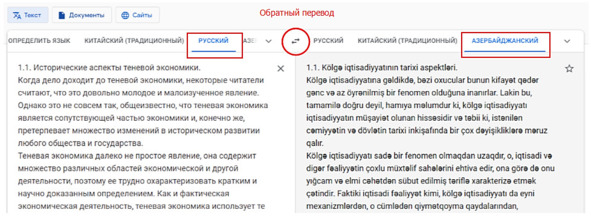
Рисунок 12 — Устанавливаем языки, исходный текст, вставляем в левое окно переводчика GOOGLE, полученный перевод, подвергаем обратному переводу

Рисунок 13 — Исходный текст вставляем в правое окно программы AntiPlagiarism.NET (интерфейс: операции — сравнение текстов — метод обнаружение копий, количество шинглов — 2)
Полученный, после тройного обратного перевода текст, вставляем в левое окно программы AntiPlagiarism.NET, нажимаем кнопку — сравнить, рис. 14. В итоге мы получаем карту шинглов, которая показывает шингловое отличие текстов — 51%.

Рисунок 14 — Получение карты шинглов, состоящих из 2 слов (карта Ш2)
Интерес представляет текст, расположенный в левом окне программы AntiPlagiarism.NET. Скопируем его и вставим в WORD. Желтым цветом выделен текст, который не изменился, наша задача разбить желтые блоки, впечатывая по одному авторскому слову через один шингл, состоящий из 2 слов, рис. 15.
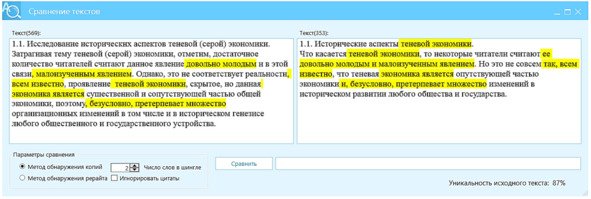
Рисунок 15 — Результат разбивки желтых блоков, отличие текстов Ш2 составило 87%
Давайте посчитаем, тройной обратный перевод дал снижение трудоемкости рерайта на 50%, из полученного объема мы допечатываем 30% текста. В объеме ВКР, имея 100 тыс. знаков (13 тыс. слов) мы снизили трудозатраты в 2 раза, к 50 тыс. проблемных знаков (7,5 тыс. слов) мы прибавили 1/3 — 2500 слов, которые в объеме знаков составят 16,6 тыс. знаков, или 8—10 стр. текста.
Можно ли снизить трудозатраты, да, конечно. Скопируем текст наших желтых блоков в буфер обмена и поместим в семантический анализатор текста, полученный ранжированный список ключевых слов, рис. 16, заменим методом найти и заменить.
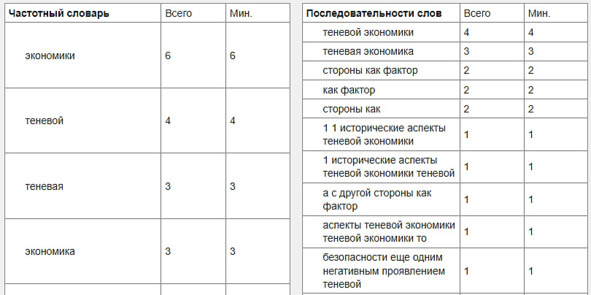
Рисунок 16 — В итоге замен мы получаем отличие текста — 70%, рис. 17
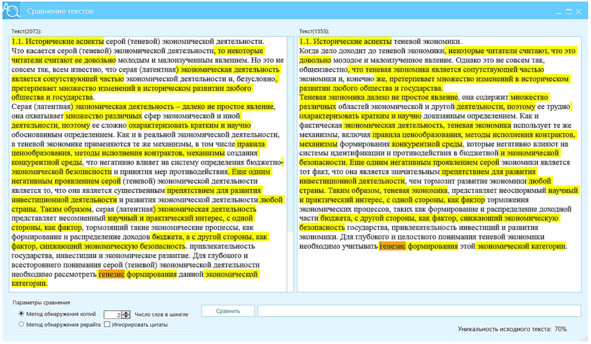
Рисунок 17 — Частотные замены высокочастотных ключей
Впечатав на каждую 1000 знаков примерно 10 авторских слов, мы получаем необходимый показатель отличия текста — 81%, рис. 18.

Рисунок 18 — Ручная разбивка 10% оставшихся шинглов
Объединение методов обратного перевода и высокочастотных замен дает ок. 70% уникальности текста. Как видно из рис. 18 ручной работы остается не более 10%. Мы снизили трудозатратность, в пересчете на ВКР, с 2500 слов, которые в объеме знаков составят 16,6 тыс., до 833 слов, 5,53 тыс. знаков.